 KONSİL
Etik kurul formundaki "örneklem büyüklüğü ve güç analizi" satırı, çoğu tezin en geç yazılan ve en az anlaşılan bölümüdür. Sık verilen cevap bellidir: bir G*Power ekran görüntüsü, α=0.05, güç=0.80 ve nereden geldiği belli olmayan bir etki büyüklüğü. Kurullar bunu giderek daha sık geri çeviriyor — haklı olarak, çünkü sorun hesap değil, hesaptan önce verilmemiş iki karardır. Bu yazı o iki kararı, parametrelerin uydurulmadan nereden bulunacağını ve herkesin atladığı prevalans adımını anlatıyor.
Karar 1: Tahmin mi, test mi?
Güç analizine oturmadan önce sorulacak ilk soru şudur: bir şeyi tahmin mi ediyorsunuz, iki şeyi karşılaştırıp fark mı test ediyorsunuz? İkisi farklı matematik ister ve çok farklı örneklem verir.
- Tahmin (kesinlik tabanlı): "Bu testin duyarlılığı nedir?" sorusu bir hipotez testi değildir; bir oranı belirli bir güven aralığı genişliğiyle tahmin etme işidir. Gereken örneklem, hedeflediğiniz aralık yarı-genişliğinden çıkar. Tanısal doğruluk çalışmalarının çoğu bu sınıftadır ve G*Power'ın klasik test menüleri bu soruya cevap vermez[1].
- Test (güç tabanlı): "A yöntemi B'den iyi mi?" sorusu bir hipotez testidir; örneklem, yakalamak istediğiniz en küçük anlamlı farktan (etki büyüklüğünden) çıkar[2].
Somut fark: duyarlılığı 0.85 beklenen bir testi ±0.05 kesinlikle tahmin etmek yaklaşık 196 hastalıklı olgu ister. Aynı çalışmayı "duyarlılık %80 eşiğinden yüksek mi" diye bir test olarak kurarsanız bambaşka bir sayı çıkar. Kurul metninde hangi soruyu sorduğunuzu yazmadan verdiğiniz her n, hakem için sorgulanabilir bir sayıdır.
Karar 2: Parametreler nereden gelecek?
Hiçbir formül, içine koyduğunuz parametreden daha güvenilir sonuç vermez. Üç meşru kaynak vardır; "makul göründü" bunlardan biri değildir:
- Yayımlanmış literatür. Etki büyüklüğünü tahmin etmeyin; en yakın çalışmanın rapor ettiği ortalama ve standart sapmadan türetin (Cohen d = ortalamalar farkı / havuzlanmış SS)[2]. Kurul metnine o çalışmanın atıfını yazın — "etki büyüklüğü 0.5 alınmıştır" ile "etki büyüklüğü X ve ark. (2023)'ün rapor ettiği ortalamalardan d=0.52 olarak türetilmiştir" arasındaki fark, başvurunun kaderini değiştirebilir.
- Kendi ön veriniz. Pilot çalışma ya da arşiv taraması; özellikle uyuşmayan çift oranı ve prevalans gibi yerel parametrelerde literatürden daha doğrudur.
- Kural gereği sabitler. α=0.05 ve güç=0.80 gelenektir; bunları kaynaklamak gerekmez ama tek yanlı/çift yanlı seçimini gerekçelendirmek gerekir[3].
Parametreyi bulamıyorsanız sayı uydurmayın; duyarlılık tablosu yazın: "beklenen duyarlılık 0.80 ise n=..., 0.85 ise n=196, 0.90 ise n=141." Kurul, tek bir uydurma sayıdan çok, kararın örnekleme etkisini gösteren dürüst bir tabloya güvenir — ve danışmanınızla konuşacağınız şey tam olarak bu tablodur.
Hangi tasarım, hangi yöntem?
| Sorunuz | Yöntem | İstediği parametreler |
|---|---|---|
| Duyarlılık/özgüllük ne? (tahmin) | Kesinlik tabanlı oran (Wilson aralığı)[1] | beklenen oran, aralık yarı-genişliği |
| İki bağımsız grup ortalaması farklı mı? | İki örneklem t-testi | Cohen d (yayından türetilmiş) |
| Aynı hastada önce/sonra? | Eşleştirilmiş t-testi | eşleştirilmiş d ya da d + ölçümler arası korelasyon |
| İki oran farklı mı? | İki oran z-testi | her iki oran |
| İki testi AYNI hastalarda karşılaştırma | McNemar | uyuşmayan çift oranları (p10, p01) |
| Üç+ grup ortalaması? | Tek yönlü ANOVA | Cohen f, grup sayısı |
| "En az onun kadar iyi" iddiası | Non-inferiority | klinik gerekçeli sınır (margin), SS[3] |
McNemar satırı özel dikkat ister, çünkü eşleştirilmiş tanısal çalışmaların en sık hatası buradadır: örneklemi belirleyen şey iki testin duyarlılık farkı değil, uyuşmayan çift oranıdır. İki test olguların %95'inde aynı kararı veriyorsa, fark büyük görünse bile devasa örneklem gerekir. Örnek: yalnız A'nın yakaladığı %15, yalnız B'nin yakaladığı %5 ise yaklaşık 155 çift gerekir — ve bu iki oran, duyarlılık farkından türetilemez; pilot veriden ya da iki testi birlikte uygulamış bir yayından gelmek zorundadır[4].
Herkesin atladığı adım: prevalans
Hesap "196 hastalıklı olgu" dediğinde iş bitmez; asıl fizibilite sorusu şimdi başlar: 196 hastalıklı olguyu bulmak için kaç kişiyi taramanız gerekir? Hedef popülasyonunuzda hastalık prevalansı %20 ise cevap 196 değil 980 taramadır. Aylık hasta hacminizle bu sayıyı bölmeden "tek merkezde bir yılda biter" cümlesi yazılamaz — ve bölünce çoğu zaman ikinci bir merkez gerektiği ortaya çıkar. Prevalansı genel popülasyondan değil kendi merkezinizin hasta profilinden alın; sevk merkezinde prevalans genel rakamın birkaç katı olabilir.
Son düzeltme kayıplardır: değerlendirilemeyen görüntü, eksik altın standart, çekilme. Beklenen kayıp %10 ise 196'lık hedef 218'e şişirilir (n / (1 − kayıp)). Kayıp oranını da tahmin etmeyin; kendi arşivinizdeki teknik yetersiz tetkik oranına bakın.
Kurul metnine yazılacak cümle
Bütün bu adımların çıktısı, kurul metninde tek bir paragraftır. Şablonu şu:
"Çalışmanın birincil amacı [tahmin/karşılaştırma]. [Parametre], [atıf]'ta rapor edilen [değer]den türetilmiştir. α=0.05 (çift yanlı) ve güç=0.80 ile gereken örneklem [yöntem] kullanılarak n=196 hesaplanmıştır. Merkezimizde beklenen prevalans (%20, kendi arşiv verimiz) dikkate alındığında yaklaşık 980 ardışık olgunun taranması, %10 değerlendirilemeyen tetkik payıyla birlikte hedefin 218 olguya çıkarılması planlanmıştır."
Bu paragraftaki her sayının bir kaynağı var; hakem hangisini çekiştirirse çekiştirsin arkasında bir atıf ya da arşiv verisi bulacak. Güç analizi bölümünün "geçmesi" tam olarak budur.
Sık yapılan beş hata
- Tahmin sorusuna test matematiği uygulamak (ya da tersi) — Karar 1 atlanınca olan şey.
- Etki büyüklüğünü "orta" almak. Cohen'in 0.5'i bir gelenek değil, son çaredir; yayından türetilebiliyorsa türetilmelidir[2].
- Prevalans adımını atlamak. "196 hasta" yazıp 980 tarama gerektiğini veri toplamaya başlayınca fark etmek — telafisi en pahalı hata.
- Çalışma bittikten sonra güç hesabı (post-hoc power). İstatistiksel olarak bilgi taşımaz; kurulun istediği şey bu değildir[3].
- Çoklu karşılaştırmayı unutmak. Üç ikili karşılaştırma planlıyorsanız α düzeltilir (ör. Bonferroni: 0.05/3) ve örneklem düzeltilmiş α ile yeniden hesaplanır.
G*Power ile adım adım: iki grup karşılaştırması
Teoriyi en çok kullanılan araçta somutlaştıralım. G*Power, Düsseldorf Üniversitesi'nin ücretsiz güç analizi programıdır ve kurul dosyalarında en sık atıf verilen araçtır. İki bağımsız grup t-testi için akış (ekran görüntüleri Ağustos 2026, G*Power 3.1):
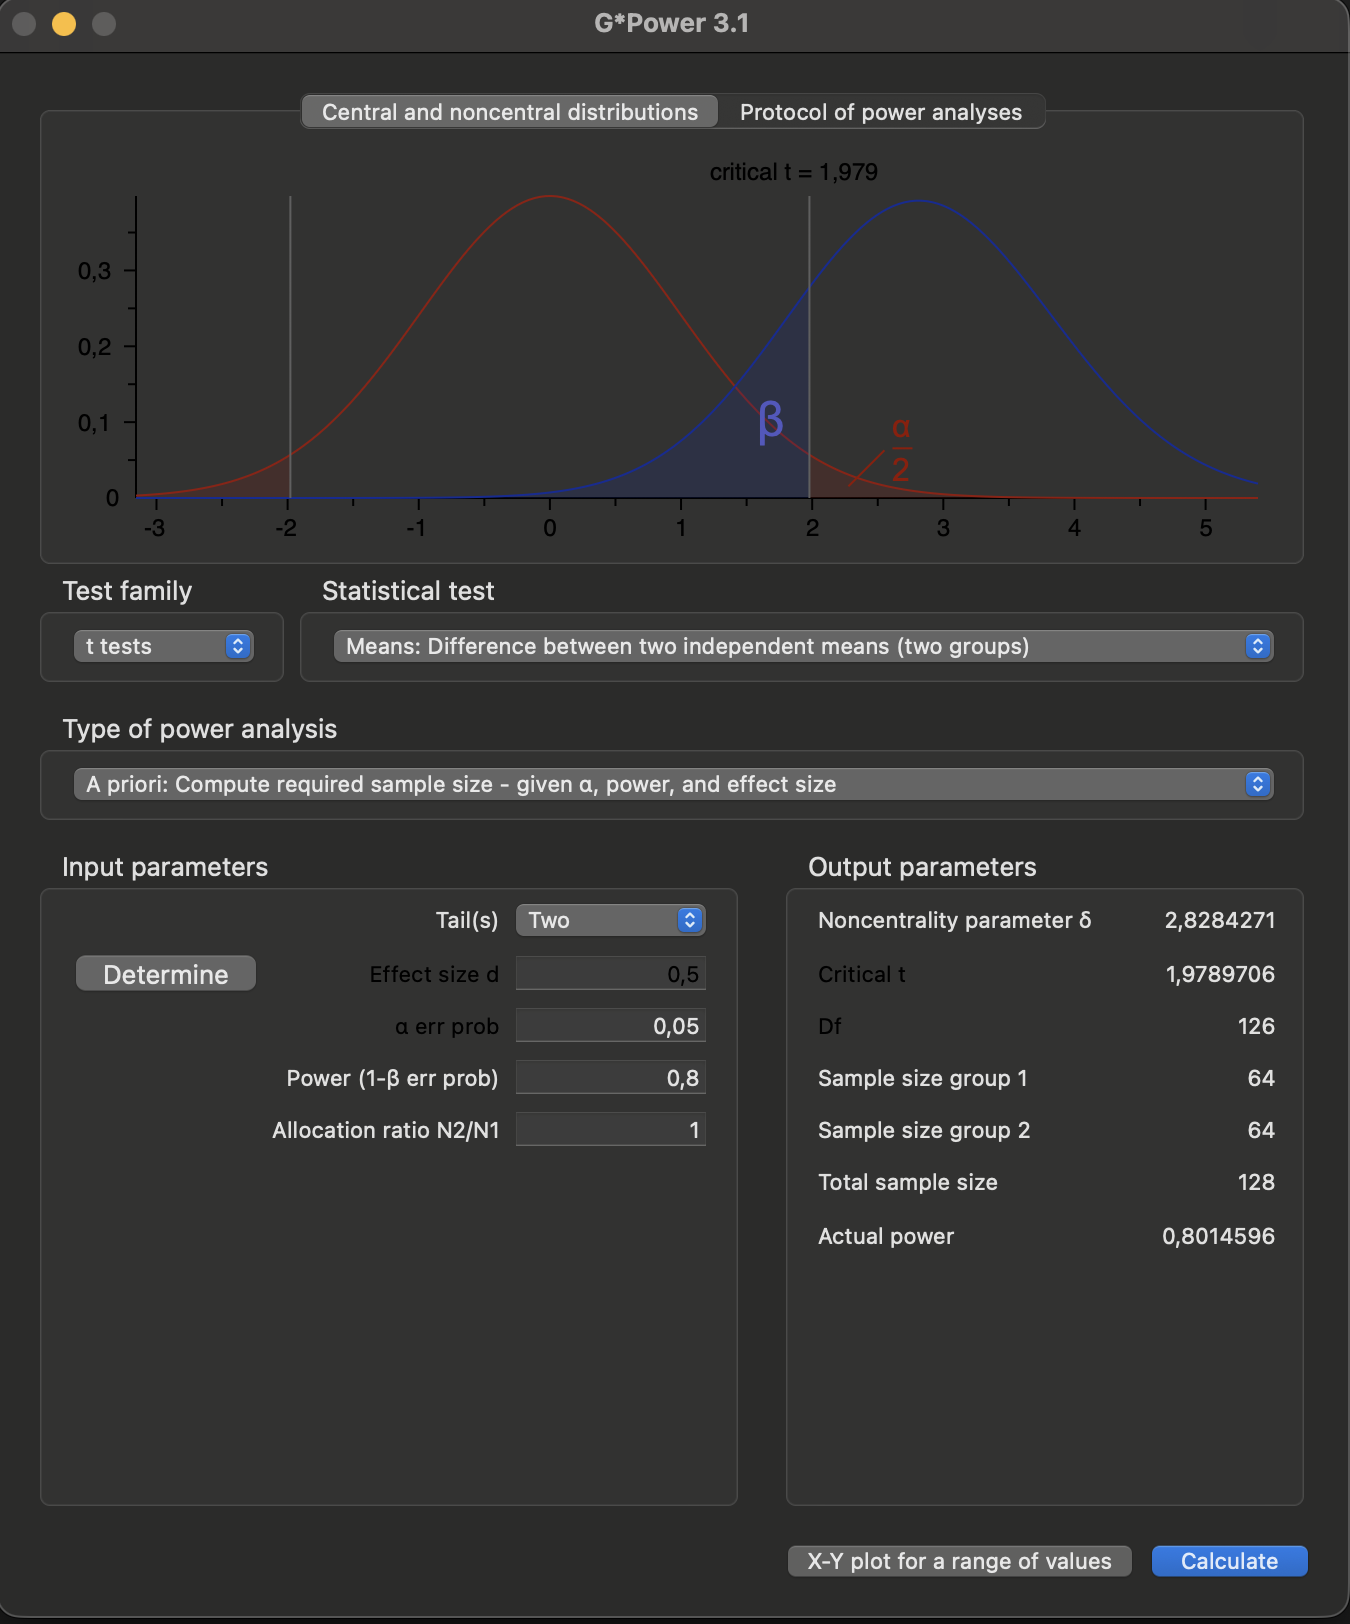
- Test family: "t tests" → Statistical test: "Means: Difference between two independent means (two groups)"
- Type of power analysis: "A priori: Compute required sample size"
- Girdiler: Tail(s) = Two · Effect size d = 0.5 · α = 0.05 · Power = 0.80 · Allocation ratio = 1
- Calculate → sonuç sağ sütunda:
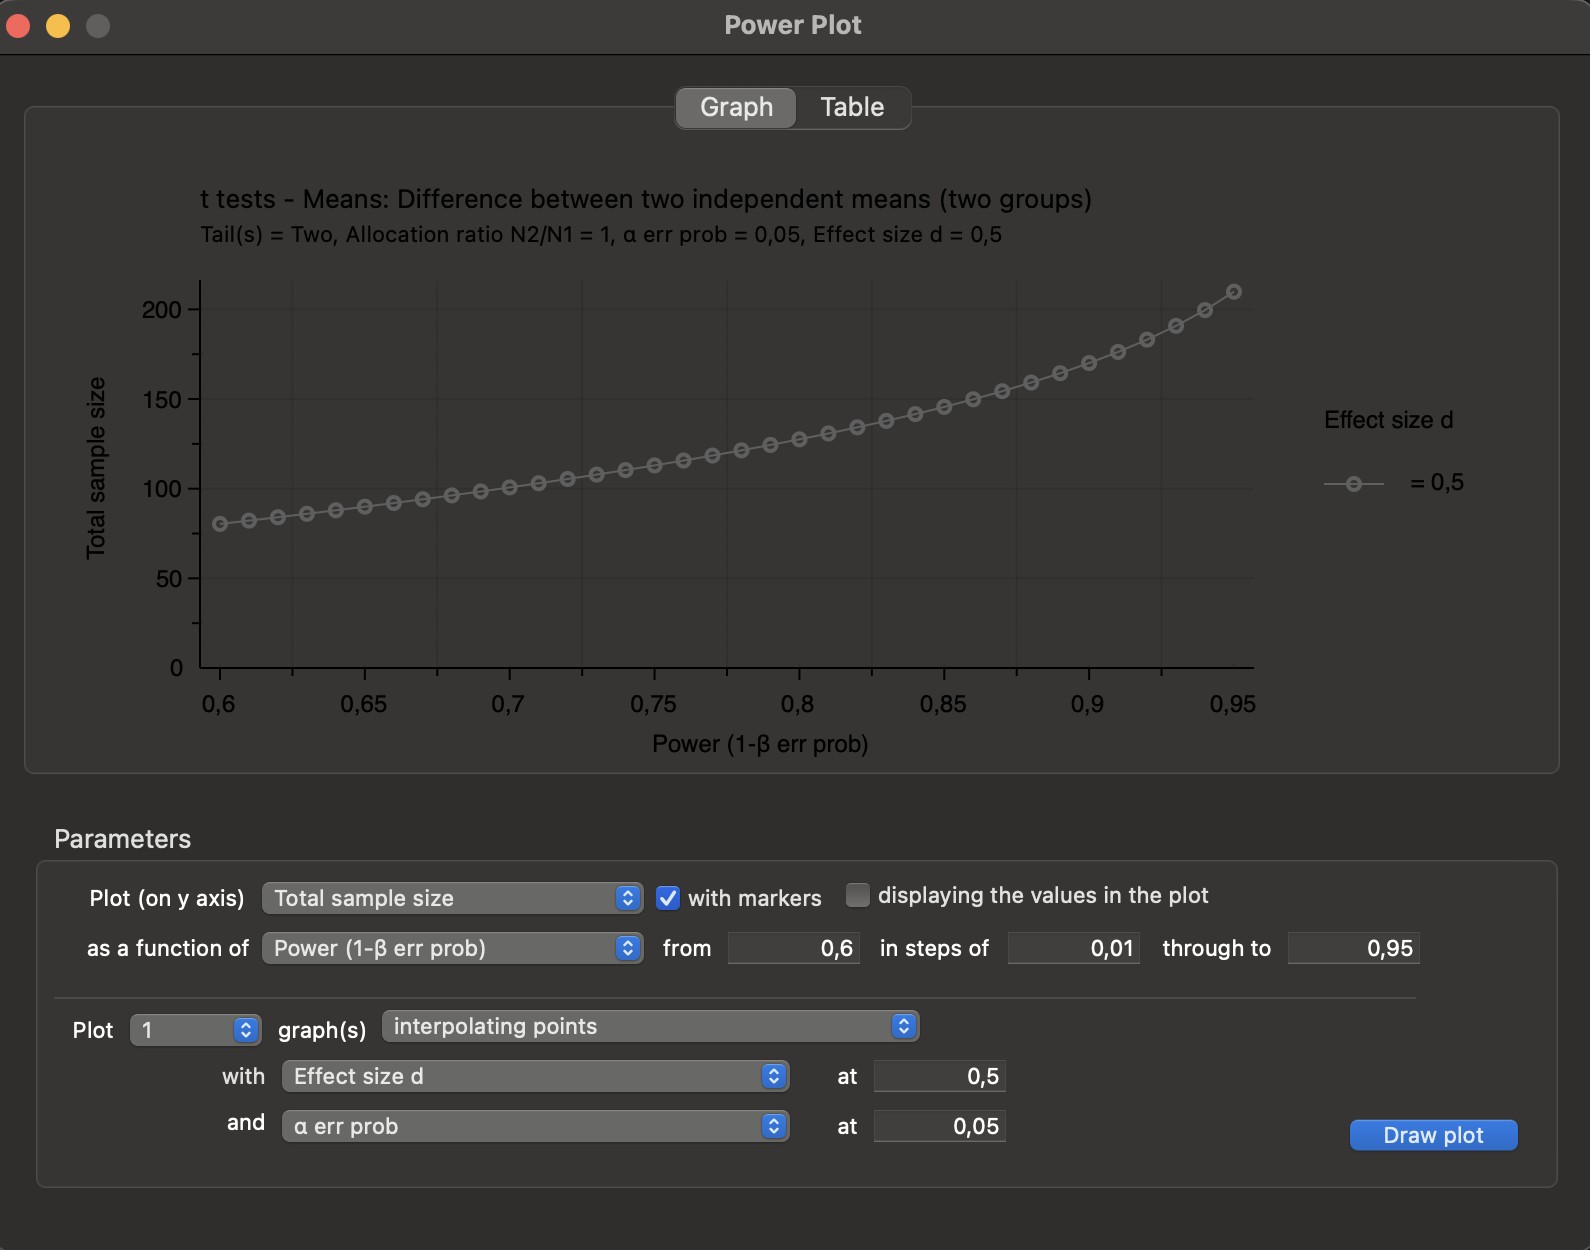
Aynı ekrandaki "X-Y plot for a range of values" düğmesi, kurul metnine koyulabilecek en öğretici grafiği çizer — güç hedefini yükseltmenin örnekleme maliyetini gösterir (0,80 → 0,95 çıkmak toplamı 128'den ~210'a taşır):
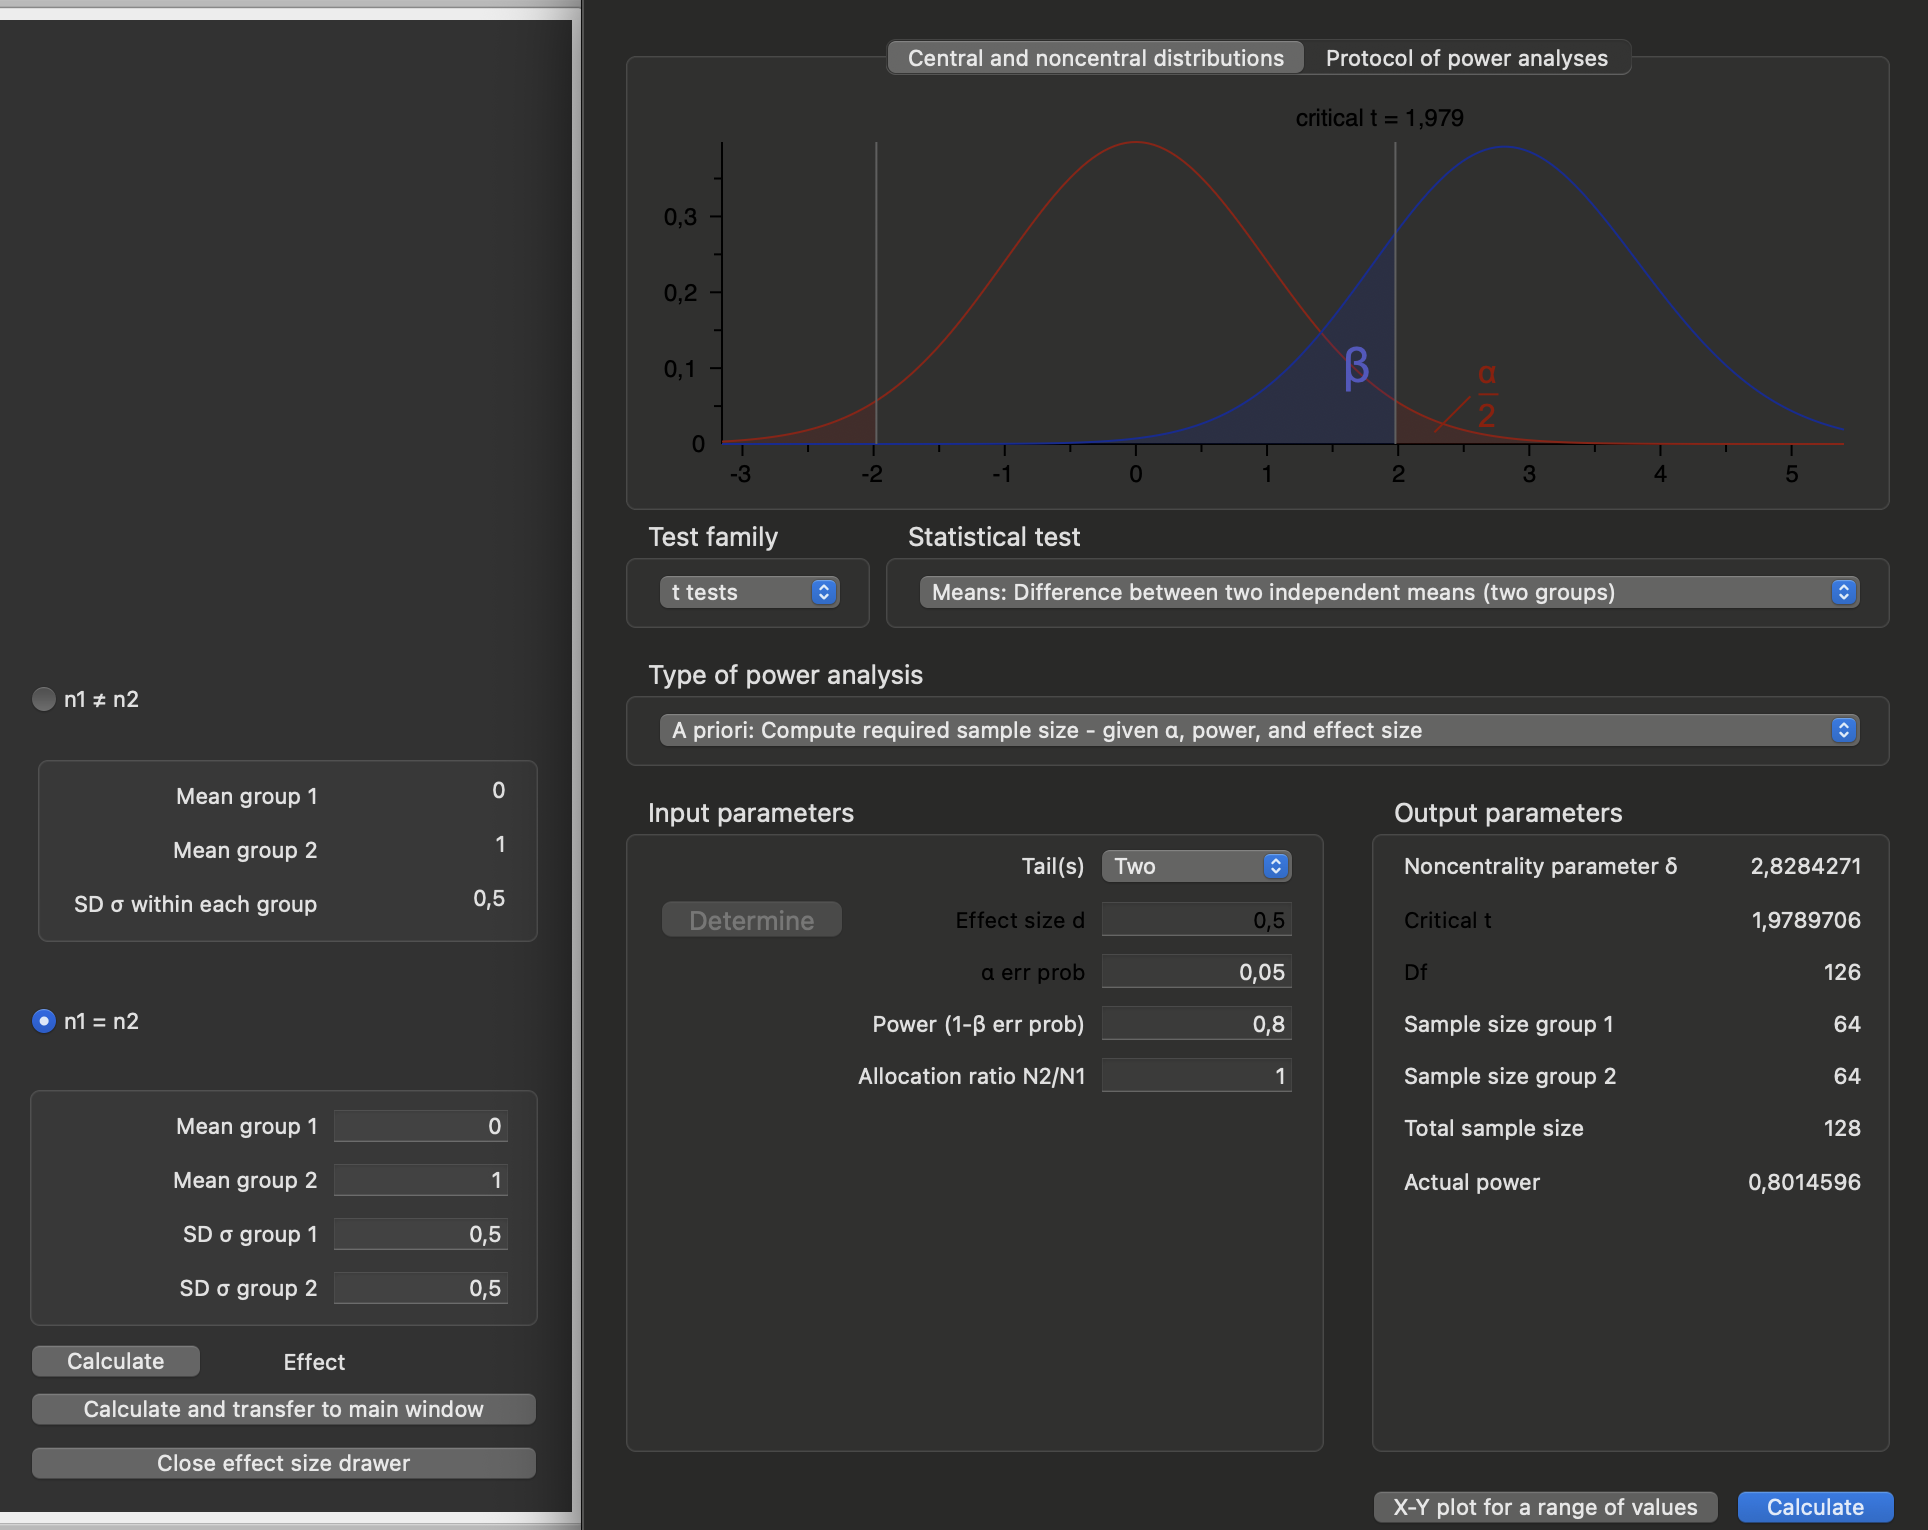
Peki d=0,5 nereden geldi? Uydurulmaz — "Determine" düğmesi yandan bir çekmece açar: kaynak yayındaki grup ortalamalarını ve standart sapmaları girersin, d'yi program hesaplar ve "Calculate and transfer to main window" ile ana ekrana taşır:
Doğrulama notu: Bu sayfadaki 128 sonucu keyfî değil: KONSİL'in kendi deterministik hesap katmanı da (formülleri G*Power, R pwr ve statsmodels çıktılarıyla test edilir) aynı girdilerle aynı sayıyı verir. Hangi aracı kullanırsan kullan, girdilerin kaynaklıysa sonuç savunulabilirdir.
Kaynaklar ve standartlar
- Newcombe RG. Two-sided confidence intervals for the single proportion (1998) — Wilson aralığının Wald'a üstünlüğü; kesinlik tabanlı örneklemin temeli.
- Cohen J. Statistical Power Analysis for the Behavioral Sciences (1988) — etki büyüklükleri ve güç analizinin klasik kaynağı.
- ICH E9: Statistical Principles for Clinical Trials — tek/çift yanlılık, non-inferiority sınırı ve analiz planı ilkeleri. ich.org
- Connor RJ. Sample size for testing differences in proportions for the paired-sample design (1987) — McNemar örneklem hesabı.
- G*Power — ücretsiz güç analizi yazılımı (Faul ve ark., 2007). psychologie.hhu.de · R kullananlar için pwr paketi
- STARD 2015 — tanısal doğruluk çalışmalarının raporlanması (doğrulama yanlılığı dahil). equator-network.org
Hazır hesap: iki grup t-testi, eşleştirilmiş tasarım ve diğer yöntemler için ücretsiz hesaplayıcılar — sayılar bu rehberdeki çözücüyle aynı motordan çıkar.
KONSİL bu hesabı raporun içinde yapar — uydurmadan
Fikrinizi yazdığınızda KONSİL tasarıma uygun yöntemi seçer, parametreyi taradığı literatürden kaynaklamaya çalışır ve bulamadığında sayı uydurmak yerine size sorar — "senin değerin hangisiyse n şu olur" tablosuyla. Prevalans ve kayıp adımları dahildir; hesap deterministik kodla yapılır, dil modeline aritmetik yaptırılmaz.
Kapalı betaya başvur